تصمیمگیرندگان سازمانی، معماران شبکه و مهندسان دیتاسنتر در حال گذار از یک تغییر پارادایم بحرانی هستند؛ مهاجرت اجتنابناپذیر از شبکههای سنتی مبتنی بر پردازشگرهای مرکزی (CPU) به کلاسترهای محاسباتی هوش مصنوعی با تراکم بالای پردازندههای گرافیکی (GPU).
در این مسیر، چالش بنیادین، ایجاد سازگاری میان محدودیتهای بیرحمانه فیزیکی زیرساخت از جمله دفع حرارت شدید در رکهای ۱۰۰ کیلوواتی، تراکم بالای پورتها در معماریهای Spine-Leaf، و محدودیت فواصل کابلکشی که توسط مدولاسیون پیشرفته PAM4 تحمیل شدهاند با پیچیدگیهای پروتکلهای لایه انتقال و پیوند داده است.
مسئله اصلی در این معماری، چگونگی طراحی یک شبکه بکاند (Backend) با پهنای باند عظیم و کاملاً بدون اتلاف (Lossless) است.
چنین شبکهای باید به گونهای طراحی شود که از بروز گلوگاههای حرارتی (Thermal Bottlenecks)، افت فاجعهبار بستههای داده (Packet Loss) یا تأخیر شدیدی که بهرهوری پردازندههای گرافیکی میلیوندلاری را کاهش میدهد، جلوگیری کند.
بار کاری هوش مصنوعی قوانین توپولوژی شبکههای سنتی و معماری فیزیکی رکها را به طور کامل در هم میشکند. برای پشتیبانی کارآمد از کلاسترهای عظیم GPU، زیرساخت فیزیکی باید همگام و هماهنگ با لایه نرمافزار و پروتکلها تکامل یابد.
این مقاله، بهعنوان یک نقشه راه مهندسی عمیق، انطباق دقیق پروتکلهای شبکههای AI با استانداردهای طراحی دیتاسنتر در سالهای ۲۰۲۴ و ۲۰۲۶ را بررسی و تحلیل میکند.
یکی از بزرگترین تصورات اشتباه در طراحی زیرساخت دیتاسنتر هوش مصنوعی، نگرش یکپارچه و مسطح (Flat Topology) به معماری شبکه است.
در محیطهای سنتی سازمانی، ترافیک کاربری، ترافیک مدیریت ذخیرهسازی و ترافیک محاسباتی غالباً از طریق یک شبکه همگرا (Converged) هدایت میشوند.
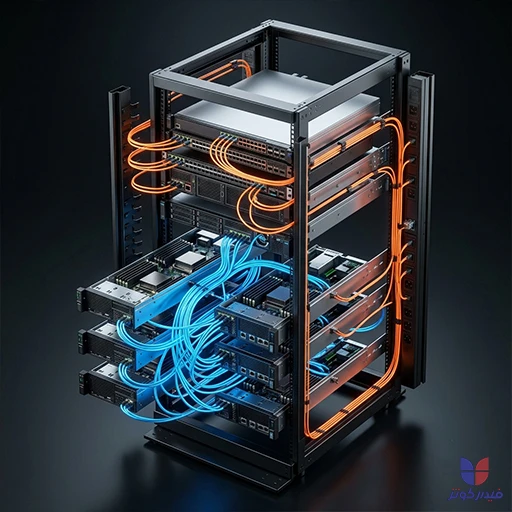
با این حال، سیستمهای مدرن هوش مصنوعی نظیر معماری کلاسترهای NVIDIA GB200 NVL72 قانوناً به یک معماری شبکهای دوگانه و کاملاً تفکیکشده در لایه فیزیکی و منطقی نیاز دارند.
این معماری، شبکه را به دو بخش کاملاً مجزا با رسالتهای متفاوت تقسیم میکند:
تفاوت اصلی میان InfiniBand و RoCEv2 برای هوش مصنوعی در چیست؟ InfiniBand یک فابریک بومیِ بدون اتلاف (Lossless) و مبتنی بر فناوری RDMA است که با استفاده از کنترل جریان مبتنی بر اعتبار (Credit-based Flow Control)، تأخیر بسیار پایینی را تضمین میکند؛ اما این پروتکل اساساً در انحصار یک تولیدکننده (NVIDIA) بوده و هزینه سرمایهای بسیار بالایی دارد.
در مقابل، پروتکل RoCEv2 قابلیتهای RDMA را به شبکههای اترنت بازگردانده و از اکوسیستم سختافزاری باز پشتیبانی میکند؛ با این حال، حفظ ماهیت بدون اتلاف در آن نیازمند تنظیمات بسیار پیچیده و شکننده در بافرهای سوئیچ (مکانیسمهای PFC و ECN) است تا از انسداد شبکه جلوگیری شود.
پروتکل InfiniBand به عنوان استاندارد طلایی و بلامنازع برای دستیابی به کمترین تأخیر ممکن در دیتاسنترهای محاسبات با کارایی بالا (HPC) تکامل یافته است.
بر خلاف شبکههای اترنت که بر پایه پروتکلهای مبتنی بر بهترین تلاش (Best-Effort) طراحی شدهاند، InfiniBand از همان ابتدا به عنوان یک شبکه کاملاً بدون اتلاف مهندسی شده است.
مزیت بنیادین این پروتکل در معماری کنترل جریان مبتنی بر اعتبار (Credit-based Flow Control) نهفته است. در مکانیسم مبتنی بر اعتبار، پورت فرستنده پیش از ارسال هرگونه داده، موجودی اعتباری پورت گیرنده را بررسی میکند. این اعتبار نشاندهنده میزان فضای خالی در بافر گیرنده است.
فرستنده تنها زمانی بستههای داده را روی لینک فیزیکی ارسال میکند که بداند پورت گیرنده ظرفیت کافی برای پذیرش آنها را دارد. این ویژگی ظریف باعث میشود که شبکه InfiniBand به صورت ذاتی در برابر سرریز بافر ایمن باشد. با این وجود، بزرگترین چالش در پذیرش گسترده InfiniBand، انحصار تکنولوژیک آن است.
تسلط کامل NVIDIA بر تجهیزات شبکهای کلاس کوانتوم، هزینههای راهاندازی (CAPEX) را به شدت افزایش داده و سازمانها را در معرض ریسک قفلشدگی فروشنده (Vendor Lock-in) قرار میدهد. این هزینه نه تنها تجهیزات اصلی، بلکه کابلهای تخصصی مربوطه را نیز در بر میگیرد.
محدودیتهای اقتصادی و نیاز به اکوسیستمهای تأمین چند-فروشندهای، صنعت را به سمت ادغام قابلیتهای RDMA بر روی زیرساخت اترنت سوق داد.
پروتکل RoCEv2 (RDMA over Converged Ethernet Version 2) این امکان را فراهم میسازد که برنامهها با دور زدن سیستمعامل (Kernel Bypass)، مستقیماً از طریق پروتکل UDP/IP به حافظه نودهای دیگر دسترسی پیدا کنند.
اما اترنت به صورت ذاتی شبکهای مبتنی بر اتلاف (Lossy) است. برای تبدیل اترنت به یک فابریک بدون اتلاف، RoCEv2 نیازمند استقرار دو مکانیزم کنترلی لایه ۲ و لایه ۳ است: ECN (Explicit Congestion Notification) به عنوان سیگنال پیشگیرانه «کاهش سرعت» و PFC (Priority Flow Control) به عنوان سیگنال واکنشی و مطلق «توقف».
برای جلوگیری از وقوع توفانهای توقف (Pause Storms) و بنبست در شبکه، تنظیم آستانه بافرها باید از یک سلسلهمراتب دقیق مهندسی پیروی کند. قانون طلایی این است: سیگنال اخطار ECN همواره باید فرصت عمل داشته باشد و در عمق صف کمتری نسبت به سیگنال توقف PFC فعال شود.
| مرحله بافر (Queue Depth) | مکانیسم فعالشده در RoCEv2 | عملکرد فرآیند (Action) | تأثیر مهندسی بر ترافیک AI |
|---|---|---|---|
| ۱. سطح پایین و امن | صفبندی عادی (Normal Queuing) | بدون اقدام؛ پکتها با سرعت خط عبور میکنند. | انتقال بینقص دادهها با حداکثر توان عملیاتی. |
| ۲. سطح متوسط (WRED Min) | آغاز ECN Marking (مقدار باینری 11) | سوئیچ فیلد ECN پکتها را با مقدار باینری 11 (CE - Congestion Experienced) علامتگذاری میکند. | گیرنده پیام CNP را به کارت شبکه مبدأ میفرستد تا سرعت به نرمی کاهش یابد. |
| ۳. سطح بحرانی (WRED Max) | علامتگذاری ۱۰۰٪ ECN | تمامی پکتهای عبوری این کلاس ترافیک با مقدار باینری 11 علامتگذاری میشوند. | کاهش شدید، فوری و پیشگیرانه سرعت ارسال پیش از نیاز به توقف کامل. |
| ۴. آستانه توقف (PFC Xoff) | Priority Flow Control (PFC) | ارسال پیام فیزیکی PAUSE به پورت سوئیچ یا سرور قبلی. | توقف کامل و سخت ترافیک. آخرین خط دفاعی برای جلوگیری از Drop. |
| ۵. فضای حاشیه (Headroom) | جذب پکتهای در حال پرواز | ذخیره پکتهایی که روی کابل بودهاند پیش از رسیدن پیام توقف. | جلوگیری فیزیکی از سرریز صف (بر اساس طول کابل و تأخیر محاسبه میشود). |
| ۶. آستانه افت (Drop Limit) | Packet Drop | حذف فیزیکی پکتها از بافر سختافزاری سوئیچ. | شکست مطلق معماری Lossless؛ توقف همگامسازی GPU. |
ائتلاف Ultra Ethernet Consortium با انتشار مشخصات نسخه 1.0.3 خود در سال ۲۰۲۶، نقشه راه قطعی شبکههای دیتاسنتر را ترسیم کرد.
این پروتکل به جای تلاش بیفرجام برای بینقص کردن شبکههای RoCEv2 از طریق پیچیدگیهای PFC، لایه انتقال شبکه را به طور اساسی بازطراحی کرده و پروتکل UET (Ultra Ethernet Transport) را معرفی نمود.
اصلیترین و انقلابیترین نوآوری UEC در لایه انتقال، جایگزینی روش سنتی ECMP (Equal-Cost Multi-Path) با تکنولوژی پیشرفته پاشش بستهها یا Packet Spraying است. در معماری ECMP، الگوریتمهای هشینگ ترافیک (Flow Hashing) تمام ترافیک متعلق به یک نشست را تنها از یک مسیر فیزیکی عبور میدهند.
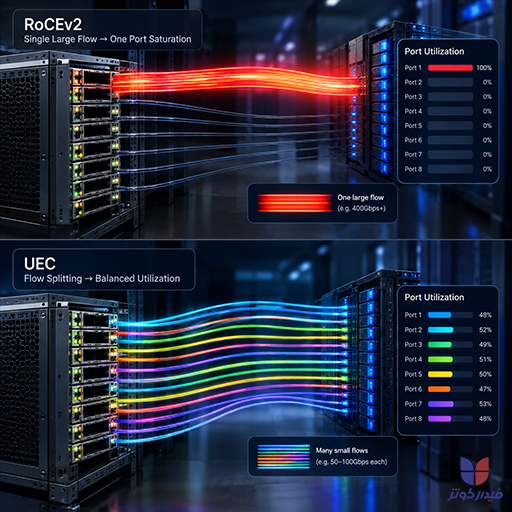
در کلاسترهای AI که با «فلوهای عظیم» (Elephant Flows) سر و کار دارند، تجمیع چند فلو روی یک لینک باعث اشباع آن پورت میشود، در حالی که لینکهای موازی خالی میمانند.
پروتکل UET با استفاده از Packet Spraying، دادههای متعلق به یک نشست را به صورت بسته به بسته تجزیه کرده و آنها را به طور یکنواخت بر روی تمام Uplinkها اسپری میکند.
از آنجا که این کار باعث میشود بستهها با تأخیرهای متفاوت و خارج از ترتیب (Out-of-order) به مقصد برسند، سیلیکونهای اختصاصی UEC با استفاده از بافرهای بازآرایی (Reorder Buffers) در لایه سختافزار، بستهها را به سرعت مرتب کرده و به حافظه تحویل میدهند.
| معیار مقایسه و ارزیابی | InfiniBand (NDR/X800) | Ethernet (RoCEv2) | Ultra Ethernet (UEC) |
|---|---|---|---|
| مکانیسم کنترل احتقان | مبتنی بر اعتبار؛ ذاتاً Lossless | ECN (هشدار) + PFC (توقف) | UET (کنترل متمرکز بر مبدأ) |
| معماری چندمسیری | مسیریابی تطبیقی در سختافزار | متکی بر ECMP | Packet Spraying |
| اکوسیستم و استاندارد | بسته و تحت سلطه یک تولیدکننده (NVIDIA) | استاندارد IEEE و Multi-Vendor | کنسرسیوم جهانی Vendor-Neutral |
| بزرگترین ریسک معماری | CAPEX فوقالعاده بالا و انحصار | خطر PFC Deadlock و ناپایداری | ریسک بلوغ فاز پذیرش اولیه |
استاندارد TIA-942-C چه الزاماتی برای ابعاد رکهای دیتاسنتر مشخص کرده است؟ بر اساس ویرایش ماه می ۲۰۲۴ از استاندارد ANSI/TIA-942-C، تمامی کابینتهای مخابراتی که در مناطق توزیع شبکه شامل منطقه توزیع اصلی (MDA)، توزیع میانی (IDA) و توزیع افقی (HDA) مستقر میشوند، قانوناً باید حداقل ۸۰۰ میلیمتر عرض داشته باشند.
این الزام برای ایجاد فضای کافی جهت مدیریت حجم انبوه کابلهای شبکه وضع شده تا از انسداد جریان هوای تجهیزات پردازشی جلوگیری گردد.
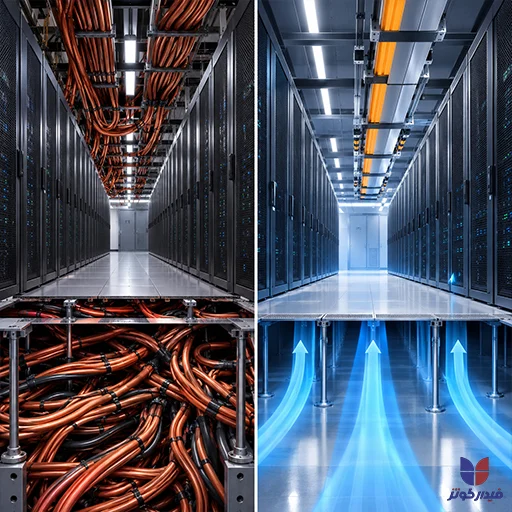
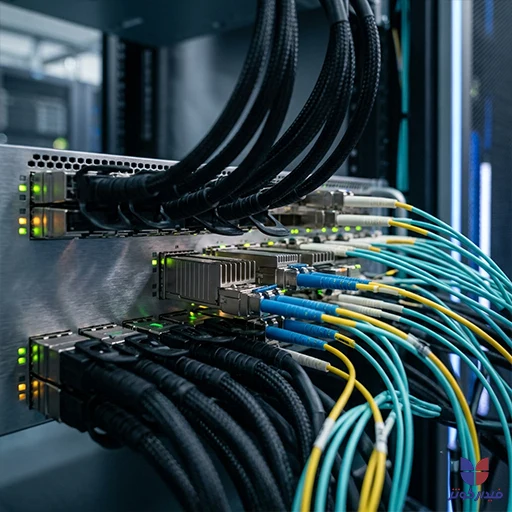
دلیل فیزیکی این الزام استانداردی، ریشه در چالشهای حرارتی دارد. در دیتاسنترهای مقیاسپذیر AI، کابلهای مسی 800G DAC و کابلهای نوری اکتیو (AOC) بسیار ضخیمتر و متراکمتر از کابلهای نسل پیشین هستند.
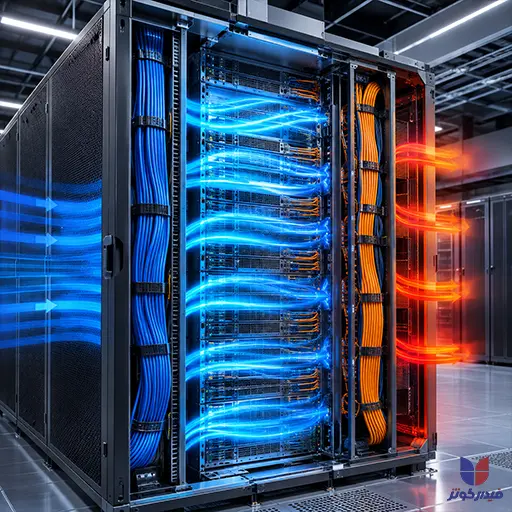
انباشته شدن این حجم از کابلها در کانالهای جانبی محدود رکهای ۶۰۰ میلیمتری، پدیدهای خطرناک به نام سد جریان هوا (Airflow Dam) را به وجود میآورد.انسداد پنلهای ورودی و خروجی هوا باعث بازگشت هوای گرم (Hot Air Recirculation) به داخل تجهیزات شده و دستگاههای تهویه مطبوع را وادار میکند با حداکثر توان کار کنند.
این مسئله میتواند بهرهوری سیستم خنککننده را بین ۲۰٪ تا ۳۰٪ کاهش دهد و به پدیده افت توان حرارتی (Thermal Throttling) در تراشههای GPU منجر شود. رکهای ۸۰۰ میلیمتری با فراهم آوردن فضای اختصاصی، مسیر تهویه تجهیزات را کاملاً باز نگه میدارند.
استاندارد ANSI/BICSI 002-2024 مکمل الزامات TIA بوده و دستورالعملهای سختگیرانهای برای زیرساخت اعمال میکند.
این استاندارد تأکید دارد کابلکشی توان الکتریکی باید در راهروی سرد (Cold Aisle) و کابلکشی داده باید در راهروی گرم (Hot Aisle) مسیردهی شوند.این تفکیک فیزیکی هم تداخل الکترومغناطیسی (EMI) را در کابلهای مسی کاهش میدهد و هم مانع از اثرات مخرب حرارت بالا بر روی سیگنالهای نوری میگردد.
همچنین، BICSI 002-2024 ضمیمههای تخصصی جدیدی را به طور خاص برای پشتیبانی فیزیکی از لولهکشی سیستمهای خنککننده غوطهوری مایع (Liquid Immersion) و سیستمهای مایع مستقیم به تراشه (Direct-to-Chip Cooling) معرفی کرده است.
| حوزه الزامات زیرساخت مهندسی | ANSI/TIA-942-C (ویرایش می ۲۰۲۴) | ANSI/BICSI 002-2024 |
|---|---|---|
| ابعاد رکهای شبکه و توزیع | الزام عرض 800mm برای کابینتهای MDA, IDA و HDA | تمرکز بر مدیریت فیزیکی کابل برای جلوگیری از انسداد عبور هوا |
| تکنولوژی کانکتورهای فیبر | صدور مجوز استفاده از کانکتورهای بسیار کوچک (VSFF) | تعیین دقیق عمق مسیرهای کابلی در زیر کف کاذب |
| طراحی فیزیکی مسیرهای کابل | توصیه به استفاده از فیبرهای تکحالته G.657.A1 (مقاوم در برابر خمش) برای داخل رک و OS2 برای بینردیفها | الزام قطعی تفکیک کابلهای برق در راهروی سرد و دیتا در راهروی گرم |
| خنکسازی و مدیریت حرارت | هماهنگی با کلاس H1 از استانداردهای حرارتی ASHRAE | معرفی ضوابط پشتیبانی فیزیکی از خنککنندههای مایع |
بر اساس مشخصات تعیینشده در استاندارد IEEE 802.3ck، دستیابی به سرعت 800G از طریق انتقال ۱۰۰ گیگابیت بر ثانیه در هر مسیر فیزیکی (100G-per-lane) و استفاده از مدولاسیون پالس دامنه ۴ سطحی (PAM4) صورت میپذیرد.
در این مدولاسیون، نرخ ارسال نماد به 53.125 GBaud میرسد.فشردگی ۴ سطح ولتاژ در یک سیکل فرکانسی باعث میشود چشم سیگنال به شدت کوچک شده و حساسیت به نویز و تداخل الکترومغناطیسی افزایش یابد. در این فرکانسها، افت درج (Insertion Loss) کانالهای مسی به شدت بالا میرود. به همین دلیل، استاندارد IEEE به صورت فیزیکی و قطعی، برد کابلهای پسیو Direct Attach Copper (DAC) را در سرعتهای 100G/Lane نهایتاً به حدود ۲ متر محدود ساخته است.
استفاده از کابلهای مسی بیش از این طول، باعث افت شدید نسبت سیگنال به نویز (SNR) شده و لینک شبکه مدام دچار قطعی میشود. این محدودیت بنیادین، کابلهای مسی DAC را منحصراً به اتصالات داخل رک (مانند سوئیچ ToR به سرورها) محدود میسازد و برای فواصل طولانیتر باید از کابلهای مسی اکتیو (AEC) یا کابلهای نوری (AOC/Transceivers) استفاده کرد.
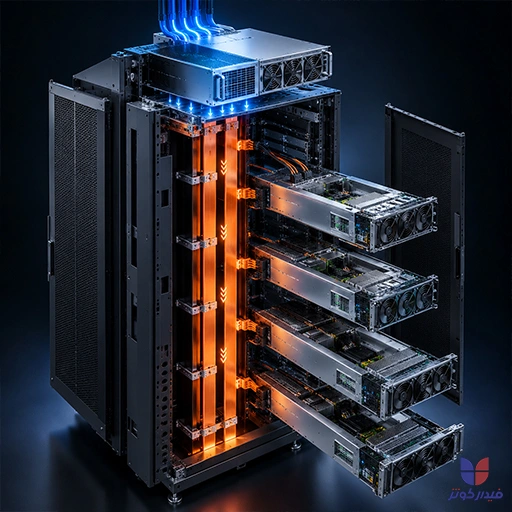
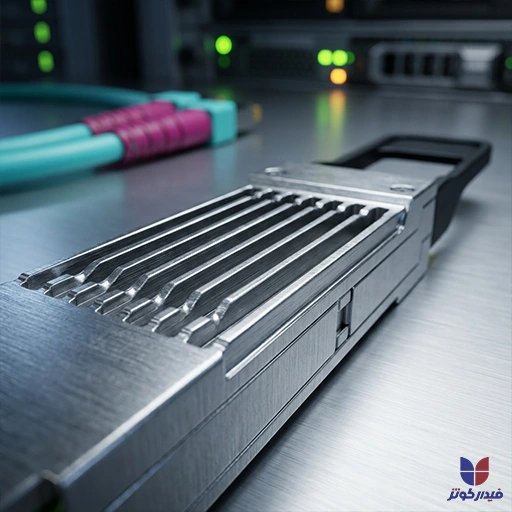
چرا فرمفاکتور OSFP برای شبکههای متراکم هوش مصنوعی 800G نسبت به QSFP-DD برتری مهندسی دارد؟ ماژولهای OSFP از نظر فیزیکی ابعاد بزرگتری دارند و با بهرهگیری از هیتسینک خنککننده یکپارچه در ساختار خود، میتوانند توانی پیوسته بین ۱۵ تا ۲۵ وات را به صورت کاملاً ایمن به هوا منتقل کنند.
این ظرفیت دفع حرارتی برتر، در کلاسترهای پرتراکم هوش مصنوعی از پدیده کاهش سرعت به دلیل حرارت (Throttling) جلوگیری میکند.
در مقابل، فرمفاکتور QSFP-DD عموماً به دفع حرارتی ۱۲ تا ۲۰ وات محدود است و در توانهای بالا ریسک سوختن لیزرهای نوری را افزایش میدهد.
| مشخصه فنی لایه فیزیکی | ماژول OSFP | ماژول QSFP-DD |
|---|---|---|
| ظرفیت حداکثر مصرف و حرارت | ۱۵ وات تا بیش از ۲۵ وات (تا ۳۳ وات در XD) | محدود به حدود ۱۲ وات تا حداکثر ۲۰ وات |
| معماری طراحی فیزیکی | دارای پرههای هیتسینک یکپارچه (Integrated fins) | متکی به هیتسینک سوار بر قفسه سوئیچ (Riding heatsink) |
| سازگاری با پورتهای نسل قبل | نیازمند آداپتور مبدل | سازگاری کاملاً مستقیم با پورتهای QSFP28 |
| استراتژی مورد استفاده ایدهآل | شبکههای Hyperscale AI و آمادگی کامل برای گذار به 1.6T | ارتقاء به 400G/800G با حفظ زیرساخت موجود و هزینه کمتر |
پیادهسازی دیتاسنتری که بتواند توان مصرفی خیرهکننده، ماژولهای نوری با حرارت ۲۵ وات، کابلهای حجیم و پروتکلهای شکننده لایه انتقال را به صورت همزمان مدیریت کند، نیازمند تخصصی جامع در حوزههای ترمودینامیک و فیزیک سیگنال است.
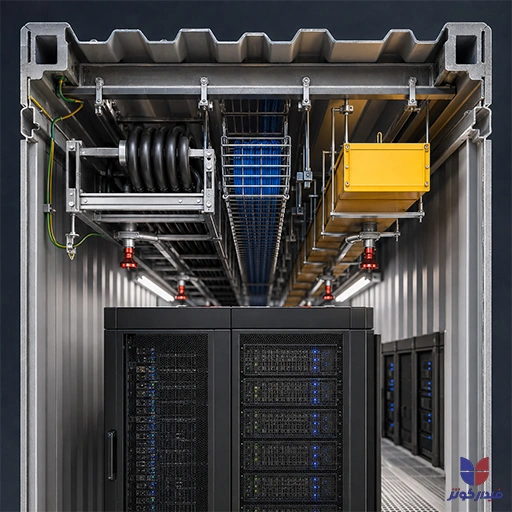
موفقیت زیرساخت نرمافزاری کاملاً در گرو استقرار فیزیکی بینقص است. گروه فیدارکوثر با تسلط بر الزامات بینالمللی از جمله استانداردهای TIA-942-C و BICSI 002، نقشههای مهندسی زیرساخت را به راهحلهای کاملاً اجرایی در پروژههای انترپرایز و در سطح طراحی کابلکشی دیتاسنتر کانتینری تبدیل میکند.
مدیران فناوری میتوانند از طریق سرویس زیرساخت های دیتاسنتر و ابزارهای محاسبه دقیق این شرکت، تخمین کارآمدی از بودجه حرارتی و نیازمندیهای شبکه به دست آورند.
چارچوب تصمیمگیری فابریک شبکه در پروژههای AI:
کلاسترهای محاسباتی AI نیازمند طراحی دقیق حرارتی، توانمند و کاملاً منطبق با استانداردهای فیزیکی و شبکهای روز دنیا هستند. گروه مهندسی فیدارکوثر آماده است تا با ارائه مشاوره تخصصی، دیتاسنتر شما را برای نسل بعدی پردازشهای سنگین تضمین و مقاومسازی کند.
درخواست مشاوره تخصصی و ارزیابی زیرساخت
بعد از ورود به حساب کاربری می توانید دیدگاه خود را ثبت کنید