فهرست مطالب
تحلیلهای استراتژیک و بررسیهای عمیق مهندسی در زیرساختهای پردازشی نشان میدهد که صنعت دیتاسنتر در حال تجربه یک تغییر پارادایم بنیادین و استراتژیک است. در دهههای گذشته و در دیتاسنترهای کلاسیک، واحد پایه طراحی و استقرار، یک «سرور مجزا» یا نهایتاً یک رک استاندارد با توان مصرفی ۵ الی ۱۵ کیلووات بود.
در آن معماری، هر سرور به عنوان یک موجودیت مستقل عمل میکرد و زیرساخت فیزیکی تنها وظیفه تامین فضای استقرار، برق متناوب و تهویه هوای سرد را بر عهده داشت. اما با ظهور مدلهای زبانی بزرگ (LLMs) با صدها میلیارد پارامتر و نیاز به پردازشهای تانسوری به شدت پیچیده، این رویکرد سنتی پاسخگو نیست.
امروزه، واحد پایه استقرار زیرساخت محاسباتی هوش مصنوعی به یک "واحد محاسباتی اتمیک و یکپارچه" به نام AI Pod تغییر یافته است.
کانتینرهای سنتی غالباً محفظههایی فیزیکی (ISO Containers) برای استقرار تجهیزات استاندارد فناوری اطلاعات با سیستمهای تهویه هوایی و PDUهای متداول هستند.
در مقابل، یک AI Pod یک بلوک ساختمانی یکپارچه، از پیشمهندسیشده و تکرارپذیر است که توزیع برق متراکم (نظیر باسبارهای دیسی ۴۸ ولت)، سرمایش مایع مستقیم تراشه (با استفاده از سیستمهای ایزوله CDU)، و فابریک شبکههای پردازش موازی در آن به صورت سیستمیک در هم تنیده شدهاند.
این مهندسی یکپارچه، امکان مدیریت بار حرارتی بیش از ۱۲۰ کیلووات در هر رک را فراهم کرده و تأخیرهای پردازشی را به حداقل میرساند. اصل اساسی در این معماری، تکرارپذیری (Repeatability) قطعی است؛ طراحی باید به گونهای مهروموم و استاندارد شده باشد که نصب پاد دهم در سایت، دقیقاً مشابه نصب پاد اول باشد و نیازی به مهندسی مجدد در محل استقرار وجود نداشته باشد.
جدول زیر مقایسهای شفاف میان معماریهای رایج زیرساخت برای درک بهتر این جهش تکنولوژیک ارائه میدهد:
| ویژگی / شاخص ارزیابی | دیتاسنتر سنتی (Enterprise) | دیتاسنتر ماژولار استاندارد | معماری پردازشی AI Pod |
|---|---|---|---|
| واحد پایه استقرار | سرور مجزا یا رکهای پراکنده | کانتینرهای ISO مجهز به IT | بلوک یکپارچه محاسباتی اتمیک |
| چگالی حرارتی (توان رک) | ۵ الی ۱۵ کیلووات | تا ۳۰ الی ۴۰ کیلووات | بیش از ۱۲۰ کیلووات |
| فناوری اصلی سرمایش | هوایی (CRAC/CRAH) | هوایی + سیستمهای In-Row | سرمایش مایع مستقیم (CDU و TCS) |
| توپولوژی شبکه | Spine-Leaf کلاسیک | Spine-Leaf مقیاسپذیر | Rail-Optimized (بدون انسداد) |
جهش چگالی توان از میانگین دیتاسنترهای کلاسیک به ارقام نجومی ۱۲۰ تا ۱۵۰ کیلووات در هر رک برای کلاسترهای نسل جدید، استفاده از رکهای استاندارد ۱۹ اینچی مبتنی بر استاندارد EIA-310 را با چالشهای جدی مکانیکی، الکتریکی و حرارتی مواجه کرده است.
برای پاسخگویی به این تراکم متمرکز، معماری Open Rack Version 3 (ORv3) که تحت نظارت پروژه محاسبات باز (Open Compute Project) تدوین شده، به عنوان استاندارد برتر در طراحی AI Podها پذیرفته شده است.
استاندارد ORv3 عرض داخلی رک را از ۱۹ اینچ به ۲۱ اینچ افزایش داده و عمق آن را برای پذیرش تجهیزات حجیمتر توسعه داده است. این فضای افزوده صرفاً یک تغییر هندسی نیست، بلکه فضایی استراتژیک برای ادغام باسبارهای توان بالا (Busbars) در قسمت پشتی رک و استقرار منیفولدهای عمودی انتقال سیال خنککننده فراهم میآورد.
در پلتفرمهای پرچمدار هوش مصنوعی نظیر NVIDIA GB200 NVL72، وزن یک رک مایعخنک با احتساب سرورها، شینههای مسی، منیفولدهای پر از مایع و سوییچها میتواند بین ۱۳۶۰ تا بیش از ۲۲۰۰ کیلوگرم باشد. این بار متمرکز (Point Load) نیازمند بازنگری کامل در محاسبات بارگذاری کف (Floor Loading) است.
شاسیهای تقویتشده با تحمل بار استاتیک بیش از ۱۵۰۰ کیلوگرم بر متر مربع، پیشنیاز قطعی استقرار یک AI Pod محسوب میشوند.
در سطح عملیاتی، یکی از بزرگترین خطرات در سیستمهای مبتنی بر سرمایش مایع مستقیم تراشه (Direct-to-Chip Liquid Cooling)، خطر نشت سیال در هنگام سرویس و خروج سرورها است. استاندارد OCP برای رفع این چالش، استفاده از کانکتورهای Universal Quick Disconnect (UQD) با طراحی نصب کور (Blind-mate) را نهادینه کرده است.
در این معماری، شاسی سرور به صورت کشویی وارد رک شده و با هدایت ریلهای مکانیکی، اتصالات هیدرولیک UQD با خطای انطباق جبرانشونده تا ۶.۴ میلیمتر، به طور خودکار درون منیفولد عمودی قفل میشوند. همزمان، کانکتورهای برق نیز متصل میگردند.
این معماری مهندسیشده ریسک نشتی مایع در هنگام سرویس را به حداقل ممکن میرساند و تجهیزات با سرعت درج تا یک متر بر ثانیه بدون آسیب به سیستم متصل میگردند.
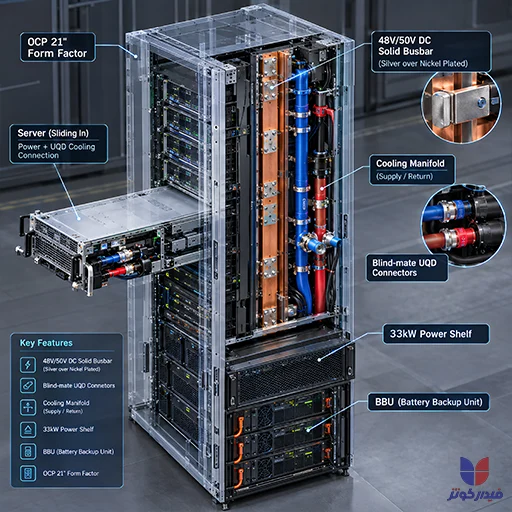
انتقال توانی معادل ۱۲۰ کیلووات با ولتاژ ۱۲ ولت کلاسیک، نیازمند جریانی بالغ بر ۱۰۰۰۰ آمپر در هر رک است که منجر به تلفات حرارتی شدید (I²R) میشود. معماری OCP ORv3 این چالش را با ارتقای ولتاژ درونرک به ۴۶ الی ۵۲ ولت دیسی حل کرده است.
جریان از طریق باسبارهای ضخیم مسی با مقاومت تماسی فوقالعاده پایین (حداکثر ۰.۵۵ میلیاهم) توزیع میشود تا افت ولتاژ در جریانهای بالا به حداقل برسد.
تغییر پلهای جریان مصرفی GPUها در فاز آموزش، به عنوان High di/dt شناخته میشود. دستگاههای UPS متمرکز، حتی دوگانه تبدیلی (Double-conversion)، نمیتوانند بدون افت کیفیت توان این شوکها را مهار کنند. ماژولهای BBU درونرک با باتریهای لیتیومی با نرخ تخلیه بالا، وظیفه تراشیدن پیک بار (Peak Shaving) را در کمتر از ۲ میلیثانیه انجام میدهند.
واحد توزیع سیال خنککننده (Coolant Distribution Unit - CDU) قلب تپنده مدیریت حرارتی AI Pod است. این واحد با استفاده از مبدل حرارتی صفحهای (Plate Heat Exchanger)، دو مدار FWS و TCS را کاملاً تفکیک میکند. این جداسازی فیزیکی تضمین میکند که در صورت نشتی در رک، تنها حجم کم مایع درون مدار TCS تخلیه شود و کل آب چیلرهای ساختمان سرازیر نگردد.
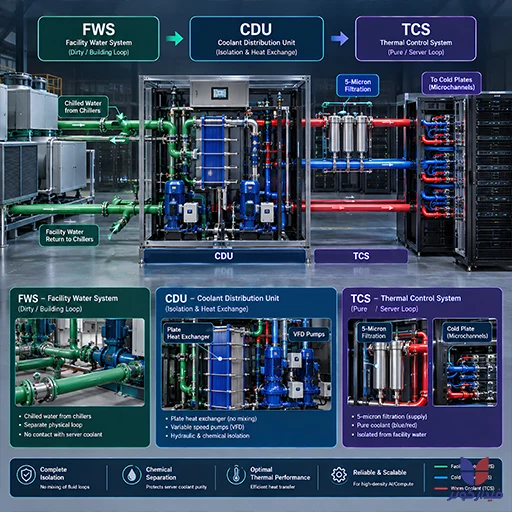
استفاده از آب کاملاً دیونیزه (DI Water) به دلیل تشنگی شدید آن به یون، باعث خوردگی گالوانیک مس در تجهیزات سرور میشود. مطابق دستورالعملهای فنی ASHRAE TC 9.9، استفاده از محلولهای حاوی بازدارنده خوردگی نظیر پروپیلن گلیکول ۲۵ درصد (PG25) استاندارد طلایی است تا خوردگی، یخزدگی و رشدهای بیولوژیک مهار شوند.
ارزیابی تحلیلی سیالات در جدول زیر ارائه شده است:
| شاخص ارزیابی حرارتی و شیمیایی | آب دیونیزه فوقخالص (DI Water) | محلول مبتنی بر PG25 با مهارکنندهها |
|---|---|---|
| ظرفیت گرمایی و انتقال حرارت | عالی | بسیار خوب (کاملاً کافی برای تراکم بالا) |
| خطر خوردگی گالوانیک (مس) | به شدت بالا (تهاجمی) | پایین (پسیو شدن سطح فلز) |
| خطر انسداد زیستی (Bio-fouling) | بالا | مصون |
کمیته ASHRAE TC 9.9 کلاسهای محیطی H1 و W4 را برای زیرساختهای پرتراکم معرفی کرده است. کلاس W4 امکان ورود سیال تا دمای ۴۵ درجه سانتیگراد را به مدار TCS مجاز میداند که امکان استفاده گسترده از سیستم سرمایش آزاد (Free-cooling) را فراهم میآورد
. با این حال، باید توجه داشت که در اقلیمهای گرم (مانند ایران و خاورمیانه) که دمای محیط به راحتی از ۴۵ درجه فراتر میرود، استفاده از درایکولرها (Dry Coolers) به تنهایی پاسخگو نیست و استفاده از چیلرهای تراکمی پشتیبان (Trim Chillers) یا سیستمهای آدیاباتیک برای حفظ پایداری حرارتی سیستم در ماههای گرم سال کاملاً الزامی است.
لایه Scale-up: ارتباطات مستقیم درون رک میان GPUها (نظیر فناوری NVLink انویدیا) را مدیریت میکند که در رکهای مدرن به پهنای باند دوطرفه ۱.۸ ترابایت بر ثانیه به ازای هر تراشه دست مییابد.
لایه Scale-out: وظیفه اتصال نودها و AI Podهای مختلف را بر عهده دارد تا از گلوگاههای انتقال داده در سطح کل دیتاسنتر جلوگیری شود.
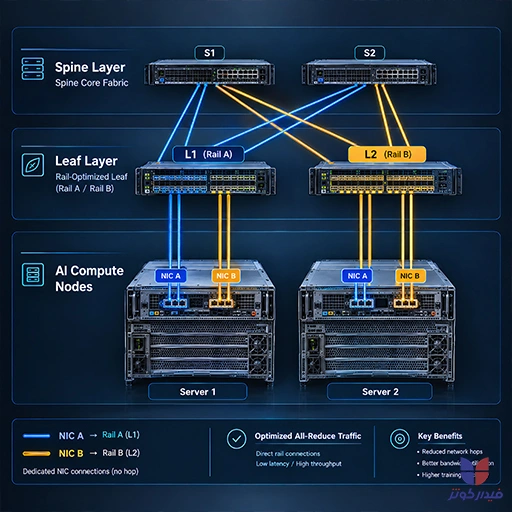
| متغیر ارزیابی فابریک | InfiniBand | اترنت استاندارد (RoCEv2) | Spectrum-X |
|---|---|---|---|
| کنترل ازدحام / افت بسته | بسیار عالی | ضعیف (ریسک Deadlock) | بسیار خوب (مسیریابی پویا) |
| وابستگی سختافزاری | به شدت بالا (بسته) | ناچیز | متوسط |
در حال حاضر، کارگروه IEEE 802.3dj استاندارد نسل بعدی اترنت را در قالب پیشنویس (Draft) توسعه داده است که نقشه راه تجهیزات آینده را شکل میدهد. این پیشنویس پشتیبانی از سرعتهای ۲۰۰، ۴۰۰، ۸۰۰ گیگابیت و به ویژه ۱.۶ ترابیت بر ثانیه (1.6T) را ممکن میسازد.
انتقال داده در این سطح چالشهای تاخیر (Latency) در تصحیح خطای پیشرو (RS-FEC) ایجاد میکند که نیازمند راهکارهای Bypass در کدهای داخلی تجهیزات است.
یک AI Pod هرچند در داخل خود دارای افزونگی الکتریکی و پردازشی است، اما به شدت به پایداری منابع زیرساختی خارجی وابسته است؛ به ویژه منبع تامین آب صنعتی پایدار (برای تغذیه سیستم FWS خنککننده در مقیاس مگاوات) و مسیرهای دوگانه و ایزوله فیبر تاریک (Dark Fiber) برای لایه Scale-out بین سایتها.
قطع طولانیمدت هر یک از این دو منبع به معنای ایجاد نقطه خرابی منفرد (Single Point of Failure) برای کل عملیات کلاستر پردازشی خواهد بود و استقلال و ماژولار بودن رک به تنهایی نمیتواند جایگزین این وابستگیهای فیزیکی گردد.
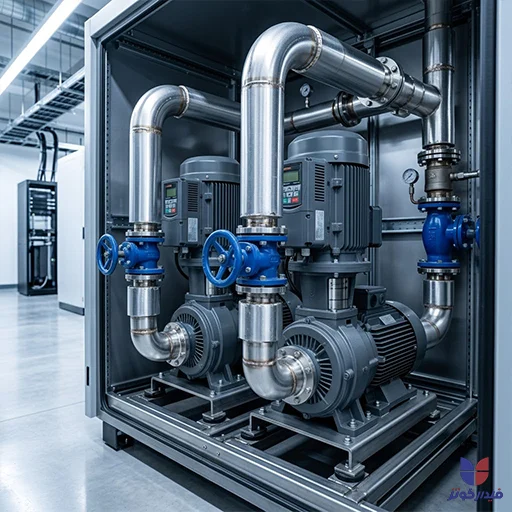
حفظ دسترسیپذیری در کلاسترهای پرهزینه GPU الزامی است. توقف فرآیند آموزش مدل به دلیل قطعی برق به معنای اتلاف هزینه محاسباتی شدید است. طراحی بر اساس کلاسهای ۳ (Concurrently Maintainable) و ۴ (Fault Tolerant) در استاندارد ISO 22237، به ویژه دوگانهسازی برقِ پمپهای سیستم CDU، رویکردی اساسی در حفظ تابآوری است.
جدول زیر تحلیل مدولهای خرابی و مکانیزمهای کنترل ریسک مهندسی را نشان میدهد:
| سناریوی بحرانی خرابی | اثرات مهلک بر سیستم | مکانیزم کنترل و کاهش ریسک |
|---|---|---|
| توقف پمپهای خنککننده CDU | وقوع فرار حرارتی سریع و خاموشی سختافزاری کلاستر | استفاده از پمپهای VFD افزونه (Redundant) و رصد تلهمتری |
| بنبست شبکهای در ترافیک (Deadlock) | مسدود شدن جریان All-Reduce و توقف همگامسازی GPUها | مسیریابی تطبیقی (Adaptive Routing) مانند Spectrum-X |
آیا دیتاسنتر سازمان شما برای پذیرش پردازندههای پرچمدار و حرارت بالای ردیفهای هوش مصنوعی آماده است؟ تیم مهندسی زیرساخت فیدارکوثر آماده ارائه خدمات مشاوره طراحی و یکپارچهسازی سیستمهای پیچیده Power و Cooling برای دیتاسنترهای ماژولار شماست.
دریافت مشاوره مهندسی زیرساخت
بعد از ورود به حساب کاربری می توانید دیدگاه خود را ثبت کنید